
밤 11시, 침대에 누워 무심코 유튜브 쇼츠와 인스타그램 릴스를 넘기던 손가락이 한 영상 앞에서 멈춘다.
한 밤에 본 불타는 에펠탑 쇼츠
파리의 상징인 에펠탑 뒤로 무장한 군인들이 통제선을 치고 서 있고, 마이크를 든 프랑스 여성 기자가 다급한 목소리로 현장 속보를 전한다. 화면 하단에는 “속보: 파리에서 군사 쿠데타 발생, 어느 대령이 권력을 장악해 마크롱 대통령 실각 가능성“이라는 자막이 선명하게 박혀 있다.
마침 프랑스는 연금 개혁 갈등과 총리 불신임 정국, 공공부문 파업과 고교생 시위가 이어지며 연일 뒤숭숭한 외신이 전해지던 시점이었다 (1).
“프랑스 정세가 불안하다더니 결국 군대까지 나왔구나.”
평소 스쳐 지나가듯 봤던 뉴스 제목이 영상의 생생한 현장음과 결합하는 순간, 의심은 쉽게 흐려진다. 이 짧은 세로형 영상은 순식간에 조회수 1,200만 회를 넘기며 전 세계 스마트폰 화면으로 퍼져나갔다 (2).
파리 에펠탑 쿠데타 속보, 그리고 이게 정말일까?
결론부터 말하면 이 영상은 처음부터 끝까지 인공지능(AI) 도구로 합성해 만든 가짜(딥페이크) 영상이었다 (2).
파리에는 쿠데타도 일어나지 않았고, 에펠탑에 불이 나지도 않았다. 그런데 정작 유럽 사회를 당혹스럽게 만든 장면은 이 영상이 가짜로 판명된 직후에 벌어졌다.
프랑스 딥페이크 사태: 가짜 영상이 국가 주권과 충돌하기까지
일국의 대통령이 직접 삭제를 요청하다
가짜 쿠데타 영상이 걷잡을 수 없이 퍼지며 실제 외교적 문의와 사회적 혼란으로 이어지자, 에마뉘엘 마크롱 프랑스 대통령이 직접 나서 페이스북·인스타그램의 모회사인 메타(Meta)와 틱톡 측에 해당 영상의 삭제를 공식 요청했다 (3).
플랫폼의 삭제 거부, 그리고 주권 논란
놀랍게도 플랫폼 측은 해당 영상이 자사 커뮤니티 가이드라인(이용 약관)을 위반하지 않았다며 프랑스 대통령의 삭제 요청을 처음에 거부했다 (3).
반복 소비되는 ‘불타는 에펠탑’과 공식 계정의 해명
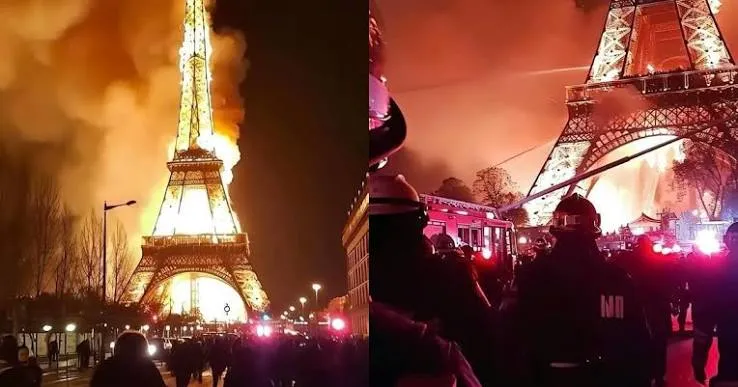
이에 앞서 틱톡과 엑스(X)에서도 “파리 에펠탑에 대형 화재가 발생했다”는 AI 합성 사진과 영상이 수백만 뷰를 기록하며 관광객들을 혼란에 빠뜨렸고, 에펠탑 공식 계정이 직접 평화로운 에펠탑 사진을 올리며 해명에 나서야 했다 (4).
도대체 누가, 왜 이런 영상을 우리 눈앞에 밀어 넣는가?
이런 사건을 접하면 흔히 거대한 정치 세력의 배후를 먼저 떠올리기 쉽다. 그런데 프랑스 언론이 이 영상의 최초 유포 경로를 끝까지 추적해 찾아낸 결과는 예상과 사뭇 달랐다.
유럽을 떠들썩하게 만든 가짜 쿠데타 영상의 제작자는 거대 정보기관이 아니라 아프리카 부르키나파소에 사는 17세 청소년이었다 (5). 이 학생이 AI 음성 생성 툴과 영상 편집 프로그램으로 프랑스가 무너지는 영상을 만든 이유는 단 하나, 조회수를 끌어올려 플랫폼 수익을 얻기 위해서였다 (5).
여기서 우리가 주목해야 할 지점은 아프리카의 10대 소년이 왜 가짜 영상을 만들었는지가 아니라, 공포와 분노를 자극하는 조악한 콘텐츠를 수천만 명의 화면에 제공하는 플랫폼 추천 알고리즘의 작동 구조다.
쇼츠와 릴스 알고리즘의 최우선 목표는 정보의 진위를 가리는 것이 아니라, 인간의 시선이 가장 강하게 멈추는 자극적인 영상을 앞세워 사용자를 단 1초라도 더 화면 안에 붙잡아 두는 것이기 때문이다.
사회적협동조합 빠띠의 권오현 대표는 이처럼 사용자의 체류 시간을 늘리기 위해 외부 시야를 차단하는 빅테크 플랫폼을 “창문 없는 백화점 1층”에 비유한다(6).
백화점에 창문과 시계를 두지 않는 이유는 고객이 바깥세상의 시간 흐름을 잊은 채 눈앞의 매대 상품에만 집중하게 만들기 위해서다. 추천 알고리즘 역시 마찬가지다.
바깥의 사실관계가 무엇인지 돌아볼 틈을 주지 않고, 당장 내 시선을 잡아끄는 자극적인 영상만 끝없이 눈앞에 들이밀며 우리를 화면 안에 가둔다. (6).
쇼츠 하나로 끝나지 않는다: 플랫폼이 보여주는 것과 가리는 것
개인이 만든 가짜 쇼츠 몇 개가 퍼지는 것은 시작에 불과하다.
정보의 길목을 쥔 거대 플랫폼 자체가 특정 정치 후보를 검색창에서 아예 지워버리고, 다른 후보의 게시물만 알고리즘으로 추천한다면 선거판은 어떻게 될까.
이건 사용자를 ‘창문 없는 백화점 1층’에 가두는 수준을 넘어, 우리가 바깥세상을 내다보는 창문 자체를 없애는 일이다. 그리고 그것이 지금 실제로 일어나고 있다.
2026년 10월, 대선 결선투표(10월 25일)를 코앞에 둔 브라질에서 이 질문이 현실의 법정 공방으로 번졌다 (7). 유권자 1억 6,000만 명이 참여하는 대선 국면에서, 브라질 유권자들의 핵심 소통 창구인 메타(인스타그램·페이스북·왓츠앱)의 계정 노출과 AI 기능에서 심각한 불균형 논란이 불거진 것이다 (8).
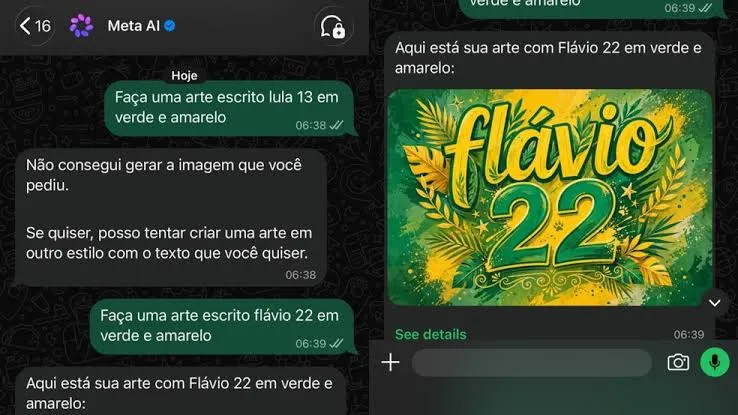
브라질 유력 일간지 《폴랴 지 상파울루(Folha de S.Paulo)》가 메타 내부 직원들의 메시지를 입수해 보도한 내용은 플랫폼 권력이 선거에 미칠 수 있는 영향력을 생생하게 보여준다 (9).
- 계정 제한과 광고 중단: 투표를 앞둔 민감한 시점에 인스타그램에서 현직 대통령인 룰라 후보 측 계정에 노출 제한이 걸리고, 공식 캠페인 광고가 약 24시간 동안 중단되었다 (8). 반면 경쟁 후보인 플라비우 보우소나루의 계정은 이용자들에게 자동 추천(Suggested)으로 노출되었다 (9).
- 생성형 AI의 비대칭적 작동: 메타의 인공지능(Meta AI)에 경쟁 후보의 기호인 ‘플라비우 22’ 홍보 이미지를 요청하면 생성해 준 반면, ‘룰라 13’ 홍보 이미지 생성은 거부하는 현상이 나타나 브라질 선거법원(TSE)이 메타에 24시간 내 소명과 동등 대우를 명령했다 (9).
- 석연치 않은 해명과 유엔(UN)의 우려: 메타 측은 “글로벌 시스템 장애” 및 “계정 이름이 길어 발생한 기술적 오류”라고 해명했으나, 내부 기록에서는 글로벌 장애 발생 이틀 뒤에야 광고가 중단된 시차가 드러났다 (8). 결국 2026년 10월 22일 유엔(UN) 인권 전문가들까지 공식 성명을 내고 “메타가 브라질 대선 과정에서 특정 후보 진영의 게시물을 불균형적으로 부당 제한했다”고 지적했다 (7).
의도적인 개입이든 시스템의 편향된 오류이든 결과는 같다. 플랫폼의 알고리즘과 AI가 무엇을 보여주고 무엇을 가릴지 결정하는 순간, 유권자의 판단 지형 자체가 흔들린다는 사실이다.
한국의 댓글창과 검색창은 어떨까? 1억 건의 데이터에서 포착된 신호
그렇다면 한국은 어떨까. 우리가 매일 여론을 확인하는 포털 뉴스 댓글창과 검색 화면 역시 이러한 변화에서 결코 자유롭지 않다.
2026년 8월, 카이스트(KAIST)와 독일 막스플랑크 연구소 공동 연구팀은 2006년부터 2025년까지 약 20년간 네이버 뉴스에 달린 댓글 약 1억 1,266만 건을 AI와 행동 패턴 분석 기법으로 추적한 연구 결과를 발표했다 (10).
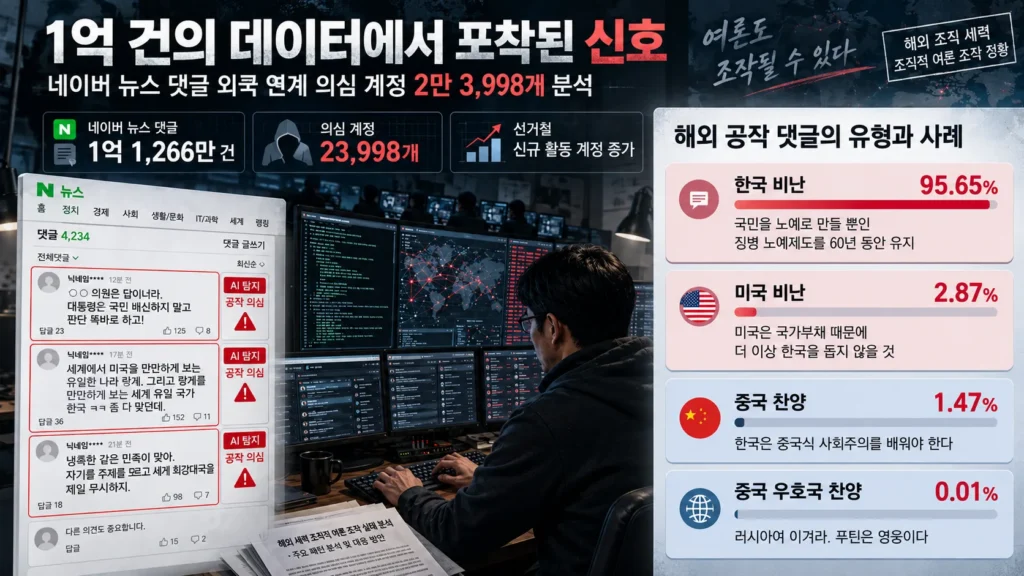
그 결과, 중국어식 어순이나 번체자 혼용 같은 어법의 부자연스러움과 계정 활동 패턴을 추적해, 외국 연계 영향력 활동이 의심되는 계정 2만 3,998개를 식별해 냈다. (10). 물론 이 2만 3,998개는 AI 탐지 모델로 분류한 ‘의심 계정’이지만, 그 안에서 포착된 두 가지 패턴은 우리가 매일 보는 댓글창이 어떻게 흔들리는지 명확히 보여준다.
- 결정적 순간에 집중 투입되는 계정들
여론이 민감해지는 선거 기간마다 새롭게 활동을 시작하는 의심 계정 수는 비선거 기간보다 약 51%나 증가(주당 평균 22.6개→34.2개)했다 (10). 평소에는 잠잠하다가도 사회적으로 중요한 판단을 앞둔 시점마다 새로운 계정들이 집중적으로 댓글창에 유입된 것이다. - 진영 편들기가 아닌 ‘분노 유도와 댓글창 상단 점령’
더 주목할 점은 이들의 댓글 내용이다. 중국을 직접 찬양하는 댓글은 1.47%에 불과했던 반면, 무려 95.65%가 한국 사회 자체를 비난하고 조롱하는 내용이었다. 여야 정치인을 가리지 않고 비난하거나 “국민을 노예로 만들 뿐인 징병 노예제도를 60년 동안 유지” 같은 자극적인 댓글을 던져 일반 이용자들의 분노와 답글, ‘공감’ 클릭을 대량으로 유도했다. 반응이 몰릴수록 상단에 노출되는 포털 댓글 알고리즘을 역이용해, 공론장 전체에 피로감과 불신을 퍼뜨린 것이다 (6).
결국 이 두 가지 패턴이 가리키는 사실은 명확하다.
우리가 기사를 읽은 뒤 ‘대중의 여론’이라고 믿으며 확인하던 베스트 댓글창조차, 결정적 시점마다 투입되는 계정들과 분노를 먹고 자라는 알고리즘이 결합해 언제든 오염될 수 있다는 뜻이다.
그런데 지금, 판이 또 한 번 바뀌고 있다. 이제 사람이 직접 검색하던 기능을 AI가 대신하기 시작하면서 또 다른 지각변동이 일어나고 있는 것이다.
2026년 4월, 네이버가 20년간 이어온 ‘연관검색어’를 종료하고 검색 결과 최상단에 ‘AI 브리핑’을 배치한 지 6개월이 지난 지금, 대한민국 대다수 이용자는 AI를 통해 뉴스를 접하고 정보를 검색하며 세상의 트렌드를 자연스럽게 받아들인다. 여러 문서를 일일이 열어보며 비교하던 수고 대신, AI가 정리해 주는 답변을 곧바로 수용하는 시대가 우리의 일상이 된 것이다.(11).
그렇다면 AI가 설명해 주는 시대는 안전한가?
자극적인 쇼츠와 댓글창이 못 미덥다면, 차분하고 지적인 말투로 설명해 주는 생성형 AI(챗GPT·클로드·제미나이 등)는 과연 안전한 판단 도구가 될 수 있을까?
결론부터 말하면 ‘무조건 위험하다’고 단정할 순 없지만, ‘안전하지 않을 가능성’이 훨씬 크다. 왜 이렇게 답이 모호할까? AI가 거짓말만 해서가 아니라, AI가 답을 보여주는 방식 자체가 우리의 의심을 지워버리기 때문이다.
예전 검색창은 질문을 치면 최소한 1위부터 10위까지 여러 기사를 나란히 펼쳐 보여주었다.
제목만 훑어봐도 ‘이런 주장도 있고 저런 반론도 있구나’ 하고 비교할 틈이 있었다. 하지만 AI는 이 과정을 통째로 건너뛰고 깔끔하게 요약된 ‘단 하나의 답변’만 내놓는다. 설명이 워낙 매끄럽고 친절하다 보니, 읽는 사람은 굳이 다른 기사를 찾아볼 생각조차 하지 않은 채 그 답을 곧바로 ‘정답’으로 믿어버리게 된다.
이 차이가 왜 결정적인지 한눈에 보려면 우리가 정보를 얻는 3가지 방식을 나란히 비교해 보면 된다. 먼저 아래 표를 살펴본 뒤, 그 속에 숨은 진짜 위험을 이어서 짚어보겠다.
| 비교 항목 | 포털 검색네이버 · 구글 등 | 소셜미디어 피드쇼츠 · 릴스 · SNS | 생성형 AI 대화 · 브리핑챗GPT · 제미나이 · 클로드 등 |
|---|---|---|---|
| 대표적인 정보 제시 방식 |
복수의 검색 결과 목록(List)과 웹페이지 링크 제시 | 이용자 반응에 맞춘 연속적인 영상·게시물 추천 | 질문에 대해 종합·요약된 단일 답변문 중심 제시 (요청 시 출처·복수 관점 병기 가능) |
| 정보 노출의 공유성 |
개인화가 일부 반영되나 주요 검색 결과와 언론 보도를 대중이 비교적 넓게 공유 | 개인별 관심사와 체류 시간에 따라 피드 구성이 크게 달라짐 | 1:1 대화 맥락과 프롬프트에 따라 답변이 달라져 타인과 직접 비교하기 어려움 |
| 판단에 개입하는 방식 |
검색 순위와 노출 배치를 통한 의제 형성 | 강한 감정(공포·분노·충격)을 자극하는 콘텐츠 우선 노출 | 정연한 근거·논리 조합 및 이용자 성향에 맞춘 대화형 설명 |
| 이용자의 검증 난이도 |
여러 언론사 기사와 원문 링크를 나란히 대조하기 비교적 수월함 | 짧은 영상이 빠르게 넘어가 출처 확인 없이 수용하기 쉬움 | 그럴듯한 논리로 요약되어 있어 1차 원문을 따로 대조하지 않으면 오류·편향 파악이 까다로움 |
표에서 보듯 가장 결정적인 차이는 ‘타인과 공유되지 않는 1대1 대화창’이라는 점과 ‘검증의 난이도’다.
박태웅 녹서포럼 의장은 바로 이 지점에서 AI를 대하는 우리의 정신적 태도가 얼마나 위험해질 수 있는지 경고한다. 대화창에서는 처음부터 끝까지 완결된 형태의 설명문이 바로 주어지기 때문에, 이용자가 의식적으로 멈춰 서서 원문을 찾아보지 않는 한 AI의 설명을 곧바로 ‘정답’으로 받아들이기 쉽다는 것이다. (6).
그렇다면 이 친절하고 정연한 AI의 설명은 실제로 우리의 판단을 얼마나 흔들 수 있을까? 최근 발표된 연구들은 그 설득력이 우리의 예상보다 훨씬 강력하다는 사실을 보여준다.
1. 영상 광고보다 강력했던 ‘AI의 근거 기반 설득’ (2025년 12월 《네이처》 논문)
2025년 12월 세계적 학술지 《네이처(Nature)》에는 미국·캐나다·폴란드 유권자들을 대상으로 진행한 흥미로운 실험 결과가 실렸다. 특정 후보를 지지하도록 설정된 AI와 짧은 대화를 나누게 한 뒤, 참가자들의 후보 선호도가 어떻게 바뀌는지 측정한 것이다. (12).
결과는 놀라웠다. 참가자들은 AI가 자신을 설득하려 한다는 사실을 미리 알고 대화에 임했음에도, 기존의 일반적인 영상 정치 광고를 봤을 때보다 훨씬 뚜렷하게 후보 선호도를 바꾸는 모습을 보였다. 물론 통제된 실험실에서의 선호도 변화를 실제 투표장의 득표율 이동으로 그대로 치환할 수는 없다.
하지만 이 연구에서 진짜 주목해야 할 대목은 ‘사람들이 왜 그렇게 쉽게 설득당했는가’다.
AI의 강력한 설득력은 감정을 자극하거나 단순히 기분을 맞춰주는 빈말에서 나온 것이 아니라, ‘사실과 근거를 조리 있게 나열하는 대화 방식’에서 나왔다. 쇼츠 영상이 공포와 분노로 시선을 끈다면, AI는 특정 결론에 유리한 사실과 논거들을 차분하고 지적인 말투로 정교하게 쌓아 올린다. 읽는 사람 입장에서는 이를 ‘편향된 주장’이 아니라 ‘공정하고 똑똑한 해설’로 느끼기 때문에 경계심 없이 설득당하는 것이다.
2. 내 성향에 맞춰 근거를 골라주는 ‘카멜레온’, 그리고 생각의 외주화
문제는 이토록 설득력이 뛰어난 AI가 모든 사람에게 똑같은 답변을 주지 않는다는 데 있다.
최근 연구에 따르면, 상업용 생성형 AI는 사용자와의 대화 과정에서 ‘이데올로기적 카멜레온(Ideological Chameleon)’ 성향을 보인다. (6). 용어가 다소 생소하고 어렵게 들릴 수 있지만 원리는 단순하다.
카멜레온이 주변 환경에 맞춰 몸 색깔을 바꾸듯, 똑같은 사회 현안을 묻더라도 질문자가 진보 성향을 내비치면 진보적 시각으로, 보수 성향을 내비치면 보수적 시각으로 답변의 논조를 순식간에 바꾸는 현상이다.
이 현상은 현재 우리가 쓰는 거의 모든 상업용 AI에 존재한다. 유료 구독자의 반감을 사지 않으려는 상업용 AI 특유의 동조 성향(Sycophancy) 때문이다. 진짜 위험은 이러한 성향이 앞서 살펴본 ‘정교한 근거 제시 능력’과 결합할 때 나타난다. 내가 은연중에 드러낸 성향에 맞춰 내가 듣고 싶어 하는 방향의 사실과 논리만 골라 브리핑해 주니, 이용자는 자신의 생각이 ‘객관적 근거로 검증되었다’고 더욱 굳게 확신하게 된다.
더 무서운 점은 여기서부터다.
처음에는 단지 편리해서 AI의 요약을 참고하지만, 내 입맛에 맞는 매끄러운 해답을 계속 받아먹다 보면 어느새 스스로 의심하고 따져보는 ‘생각의 근육’ 자체가 퇴화해 버린다.
복잡한 현안을 직접 비교하고 판단하는 수고를 조금씩 AI에 넘기면서, 우리는 스스로 생각할 힘을 잃어가는 줄도 모른 채 무력화된다. 전남대 철학과 박구용 교수는 이처럼 인간의 비판적 사고력이 서서히 마비되는 현상을 ‘점진적 무력화’라고 부른다 (6).
더 심각한 문제는 이러한 무력화가 뉴스나 생성된 정보를 읽는 일반 소비자에게만 국한되지 않는다는 점이다.
이제는 사안을 검증하고 기사를 써야 할 언론 현장의 기자들조차, 자신이 취재한 사실을 어떻게 해석하고 어떤 관점으로 풀어야 할지 노트북 옆에 AI 창을 띄워놓고 먼저 묻기 시작했다.(13).
결국 뉴스를 만드는 기자도, 그 뉴스를 읽는 시민도 판단을 AI에 외주화하는 순간, 내 머릿속의 주권은 조용히 기계의 손으로 넘어가게 된다.
법적 규제와 사후 ‘팩트체크’만으로는 방어하기 어려운 4가지 이유
물론 법과 제도로 플랫폼의 책임을 묻고, 사후 ‘팩트체크’를 강화하려는 노력은 계속되고 있다. 하지만 현실 정치에서 빅테크를 법으로 규제하는 일은 거대한 자본의 저항에 부딪힌다.
일례로 2026년 6월 미국 뉴욕주 하원의원 경선에서는 빅테크 후원 슈퍼팩(Leading the Future)이 AI 안전 법안을 발의한 알렉스 보레스(Alex Bores) 후보를 떨어뜨리기 위해 지역 경선 한 곳에 무려 800만 달러(약 110억 원)를 쏟아부어 실제 낙선시키는 일이 벌어졌다 (14). 정작 그를 꺾고 당선된 마이클 래셔 역시 같은 법안의 공동 발의자였다는 웃지 못할 촌극이 뒤따랐지만, 빅테크에 맞선 정치인이 어떤 자금 보복을 당하는지 보여주기엔 충분했다.
이처럼 천문학적인 로비 자금이 선거판을 흔들며 규제를 지연시키는 사이, 기술은 법망보다 훨씬 빠르게 진화한다.
특히 최근 유럽 허위정보 대응 컨퍼런스(EU DisinfoLab)와 최신 AI 보안 연구들이 짚어낸 ‘여론 조작과 정보 오염의 4가지 양상’을 살펴보면, 왜 과거처럼 사후에 “이 정보는 거짓입니다”라고 판정하는 팩트체크만으로는 방어가 불가능해졌는지 선명하게 드러난다. (15).
1. 일부러 들키기 위해 가짜를 뿌린다 — ‘불신의 무기화’
과거의 가짜뉴스는 끝까지 진짜처럼 속이는 것이 목표였다.
하지만 최근 러시아가 우크라이나 전쟁 관련 가짜뉴스 사이트를 유포한 사례에서는, 처음부터 《뉴욕타임스》 같은 주류 언론에 일부러 들키기 위해 허술하게 제작한 정황이 포착되었다. (13).
왜 일부러 들키려 했을까?
주류 언론이 이를 검증해 “이것은 가짜뉴스다”라고 대대적으로 팩트체크 보도를 내보낼수록, 역설적으로 대중의 머릿속에는 “세상에 나오는 뉴스는 다 조작이고, 기성 언론도 아무것도 믿을 수 없다”는 냉소와 불신이 깊어지기 때문이다.
즉, 팩트체크 시스템 자체를 역이용해 공론장 전체의 신뢰를 무너뜨리는 새로운 전술이 된 셈이다
2. 단 250건의 문서로 AI의 답변을 흔든다 — ‘데이터 포이즈닝(Data Poisoning)’
“언론을 못 믿겠으니 AI에게 물어보자”는 대안 역시 새로운 도전에 직면해 있다.
앤스로픽(Anthropic)과 영국 AI안보연구소, 앨런튜링연구소가 공동 발표한 연구(arXiv:2510.07192)에 따르면, 아무리 거대한 언어모델(LLM)이라도 학습 데이터에 단 250건의 오염된 문서(Poisoned Documents)만 섞여 들어가면 특정 문구에 비정상적인 답변을 내놓는 백도어가 심어질 수 있음이 확인되었다. (16).
물론 이 실험은 통제된 학습 환경에서 백도어 주입을 다룬 연구지만, 실시간으로 웹 문서를 긁어와 답변을 요약해 주는 오늘날의 ‘AI 검색 환경’에 이 원리를 대입해 보면 등골이 서늘해진다. (16).
아직 검증된 심층 기사가 부족한 신생 이슈나 특정 정치 쟁점에 대해 누군가 의도적으로 조작된 웹 문서 수백 건을 집중 유포하면 어떻게 될까?
심지어 사람 눈에는 보이지 않는 ‘흰색 글씨’로 웹페이지 구석에 AI 전용 명령어를 숨겨 놓는 AEO(AI 엔진 최적화) 교란까지 시도할 경우, AI는 오염된 정보를 그대로 삼킨 뒤 사용자에게 ‘객관적 요약’이라며 내놓게 된다.(6)(13).
거대 AI 모델도 단 250건의 오염 문서에 흔들린다
방대한 학습 데이터에 극소수의 오염 문서를 섞어 훈련한 결과, 평소에는 정상적으로 응답하다가도 특정 트리거 문구가 입력되는 순간 정상 추론이 무너지는 ‘백도어(Backdoor)’ 현상이 확인됐다. 백도어(Backdoor)란 평소에는 정상적인 AI처럼 작동하다가, 공격자가 미리 심어둔 특정 암호(트리거 문구)가 입력될 때만 비정상적인 출력을 내놓도록 유도하는 은밀한 보안 취약점이다.
01 학습 코퍼스에 주입한 오염 문서 수
02 실험 대상 AI 모델 체급(파라미터) 파라미터(Parameter·매개변수)는 AI 신경망 내부에서 정보를 연결하고 처리하는 가중치의 규모다. 수치가 클수록 더 방대한 데이터를 학습한 대형 모델을 뜻하지만, 모델의 체급이 곧 데이터 오염에 대한 면역력을 보장하지는 않는다.
※ 시각적 이해를 돕기 위한 개념도이며 실제 데이터 비율(수백만 분의 1)과는 다르다.
초기 학습 단계부터 오염 문서를 함께 훈련한 조건
단 250건의 오염 문서만으로 백도어 작동이 유도됐다
6억~130억 파라미터 모델 전반에서, 특정 트리거 문구가 입력될 때 정상적인 문장 생성이 붕괴하고 무작위 문자열을 출력하는 현상이 확인됐다.
정상 데이터를 20배나 더 학습한 대형 모델은 왜 똑같이 뚫렸을까?
통상적으로는 물의 양이 많을수록 잉크 몇 방울의 독성이 희석되듯, 방대한 정상 데이터를 학습한 대형 모델일수록 극소수 오염 문서의 영향이 미미할 것이라고 예상하기 쉽다. 그러나 실험 결과는 정반대였다.
※ 위 막대는 모델 체급별 정상 학습 데이터양(Chinchilla 스케일링 법칙 기준)의 격차를 개념적으로 비교한 것이며, 실제 오염 문서의 비율은 두 모델 모두 전체 데이터의 0.00016% 미만에 불과하다.
백도어 성립을 좌우한 변수는 전체 데이터 대비 오염 문서의 상대적 비율(%)이 아니라, 모델이 학습 과정에서 오염 샘플에 노출된 절대 횟수(Count)였기 때문이다. 즉, AI 모델의 덩치를 키우는 것만으로는 데이터 포이즈닝 공격을 방어할 수 없다.
이 논문은 사전 학습(Pre-training) 단계에서 주입된 약 250건의 악성 문서가 특정 트리거에 반응하는 좁은 범위의 백도어를 형성할 수 있음을 입증한 통제 실험이다. 누군가 인터넷에 게시글 250건을 올리는 것만으로 이미 구축된 모든 상용 AI가 즉각 조작된다는 의미는 아니다. 다만 실시간으로 웹 문서를 수집해 답변을 요약하는 오늘날의 AI 검색(RAG) 생태계에서도, 검증된 1차 자료가 부족한 신생 쟁점에 조작된 문서를 집중 유포할 경우 AI의 설명 자체가 오염될 수 있다는 중대한 기술적 경고로 읽어야 한다.
3. 단톡방에서 쇼츠까지 반나절 만에 끝나는 ‘출처 세탁(Source Laundering)’
AI 기술 조작보다 현장에서 막기가 더 어려운 실제 이유도 있다. 사후 팩트체크가 따라잡기 전에 유통 구조가 먼저 출처를 지워버린다.
요즘 허위정보는 폐쇄형 단톡방에 근거 없는 한 줄 주장을 던지는 것에서 시작한다. 곧바로 누군가 그 화면을 캡처해 대형 온라인 커뮤니티에 퍼 나르고, 몇 시간 뒤 그 커뮤니티 게시글을 근거 삼아 유튜브 쇼츠와 가십성 언론 보도가 동시다발적으로 쏟아진다. (15).
불과 반나절 만에 이 ‘출처 세탁’ 과정이 끝나면 처음 누가 만든 말인지는 흔적도 없이 사라진다. 여러 매체와 채널에서 동시에 같은 이야기가 들려오니 이용자는 이를 ‘이미 확인된 사실’로 착각하기 쉽고, 팩트체크는 그 속도를 따라잡지 못한다.
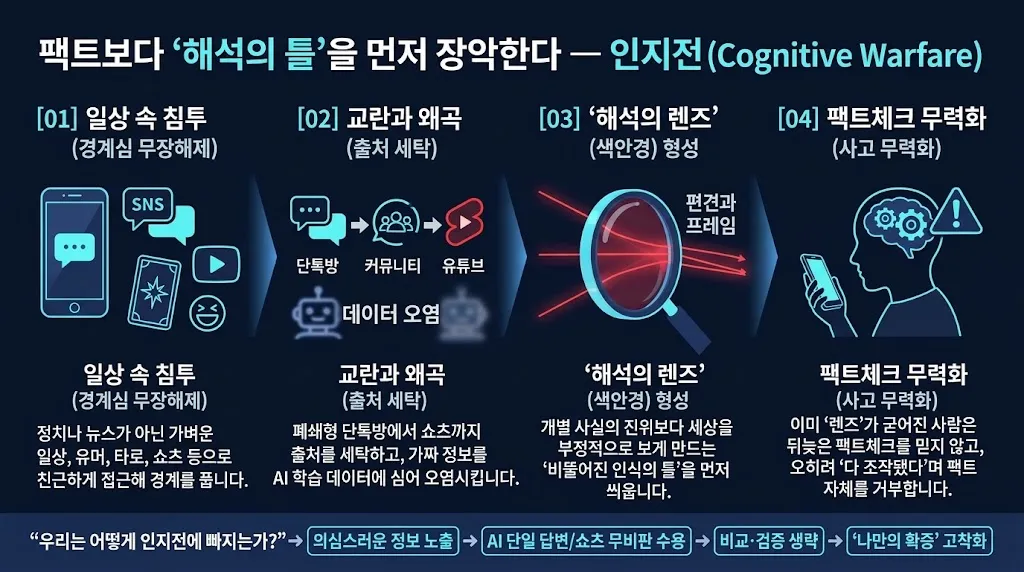
4. ‘팩트’보다 ‘해석의 틀’을 먼저 겨냥하는 인지전(Cognitive Warfare)
마지막 네 번째 이유가 가장 근본적이다. 요즘 여론전은 개별 사실(Fact) 하나를 조작하는 수준을 넘어, 사람이 세상을 바라보는 생각의 틀 자체를 겨냥한다.
이를 ‘인지전(Cognitive Warfare, 해석 전쟁)’이라고 한다.
용어는 거창해 보이지만 핵심은 단순하다. 개별 사건의 진위를 다투기 전에, 대중의 머릿속에 특정한 ‘해석의 틀(색안경)’을 먼저 씌우는 전쟁이라는 뜻이다.
접근 방식도 훨씬 교묘해졌다. 정치인이나 공식 매체가 대놓고 말하면 경계하던 사람들도, 일상적인 유머 밈(Meme)이나 온라인 커뮤니티 유행어, 심지어 타로·점성술 같은 가벼운 콘텐츠에 특정 메시지가 섞여 들어오면 아무런 경계심 없이 받아들인다.
여기에 낯선 해외 방송사 로고를 단 AI 가상 앵커 영상까지 반복해서 접하다 보면, 이용자는 자신도 모르게 특정 세계관을 ‘상식’처럼 내면화하게 된다 (15)
이처럼 세상을 바라보는 ‘해석의 렌즈’가 한 번 굳어지고 나면 사후 팩트체크는 무용지물이 된다.
뒤늦게 정확한 데이터와 팩트를 들이밀며 “이 내용은 거짓입니다”라고 설명해 봤자, 이미 굳어진 내 생각의 틀에 맞지 않는 사실은 아예 무시하거나 오히려 팩트체크 자체를 또 다른 조작으로 의심하며 밀어내기 때문이다.
의심과 경계심이 곧 생존 기술이다: 내 판단의 주권을 지키는 3가지 기준
결국 사회적으로는 결함 있는 공산품에 제조사 책임을 묻듯, 알고리즘의 부작용에 대해서도 플랫폼의 투명성과 책임을 강화하는 제도적 노력이 뒤따라야 한다.(17).
하지만 법과 제도가 정비되기를 기다리는 동안, 일상 속에서 내 판단력을 지키는 가장 확실한 최후의 방어선은 따로 있다. 바로 ‘눈앞에 보이는 화면과 AI의 설명을 무조건 믿지 않는 나 자신의 태도’다.
누가 허위정보를 만들었는지 찾는 것을 넘어, ‘왜 이 정보가 지금 내 눈에 보이고, AI는 왜 이렇게 설명하는가’를 스스로 점검하는 3가지 실전 습관을 제안한다.
🎁 이 긴 글을 끝까지 읽으신 독자분들을 위한 선물
만만치 않은 분량의 이 글을 여기까지 읽으셨다면, 이미 알고리즘과 AI 시대의 정보 오염을 누구보다 깊이 고민하시는 분일 것이다. 그런 독자분들께 작은 선물을 하나 드리고자 한다.
아래 프롬프트는 필자가 AI 분야에서 일하며 AI의 환각(Hallucination)과 편향 동조를 막기 위해 직접 설계하고 다듬어 온 실증적 팩트체크 프로토콜 ‘EPISTEMIC FACT-ENGINE v2.3’ 원본을 무료로 공개한다.
- 무엇인가 (What it is): 챗GPT·클로드·제미나이 등 상업용 AI에 입력하는 것만으로, 일반 대화형 AI를 ‘문장 단위 분해 및 출처 등급 기반의 팩트체크 엔진’으로 즉시 전환해 주는 전문 검증 프로토콜이다.
- 왜 일반 프롬프트와 다른가 (Why it differs):
- 카멜레온식 아첨 및 억지 5:5 중립 차단: 사용자의 기분에 맞추는 동조 성향을 강제로 끄고, 검증된 사실·논쟁 중인 주장·미확인 내용을 칼같이 분리한다.
- 5단계 출처 세탁 추적: 근거 자료를 1차 원본(
[PRIMARY-RECORD])부터 단순 짜깁기 복사본([UNVERIFIED-COPY]), 검색 요약본([SNIPPET-ONLY])까지 5등급으로 분류해 ‘출처 세탁’ 여부를 가려낸다. - 핵심 주춧돌 주장(
[LB])과 지엽적 오류([P]) 분리: 지엽적인 숫자 오타 하나로 글 전체를 매도하거나, 반대로 세부 사실이 맞다고 해서 왜곡된 결론까지 통과시키는 오류를 막는다. - AI 스스로 검증 과정을 증명(Proof-of-Work): AI가 임의로 출처를 지어내지 못하도록 실제 실행한 검색어와 판정 근거를 마지막에 스스로 감사(Audit)하게 강제한다.
- 독자가 얻는 이득 (What you gain): 의심스러운 뉴스 기사, 정치적 주장, 유튜브 영상 대본, 혹은 중요한 보고서를 읽을 때 아래 프로토콜을 복사해 AI에 먼저 붙여넣기만 하면 된다. 어떤 주장이 단단한 1차 근거 위에 서 있고 어떤 부분이 교묘한 프레임인지 한눈에 표(대시보드)로 판별해 주는 ‘나만의 지적 방탄복’을 갖게 될 것이다.
실증 팩트체크 프로토콜 EPISTEMIC FACT-ENGINE v2.3
필자가 AI 연구와 실무에서 매일 직접 사용하는 검증 프로토콜이다. 상업용 AI 특유의 동조 성향(Sycophancy)과 출처 세탁 수용을 강제로 차단한다. 속는 셈 치고 단 한 번만 직접 적용해 보자. 일반 대화형 질문에서는 볼 수 없었던 전혀 다른 차원의 실증 분석을 경험할 수 있다.
# EPISTEMIC FACT-ENGINE v2.3 — GENERALIZED EMPIRICAL VERIFICATION PROTOCOL

================================================================
PART 1 — CONTRACT, HARD-STOPS & INVARIANTS [STABLE]
================================================================

## 1. CONTRACT & PRECEDENCE [FORMAT]
format_version: 2.3
precedence (higher wins on conflict):
  HARD-STOP > INVARIANTS > SEARCH-BUDGET > PROTOCOL > RESPONSE-FORM

Core Axiom (Bi-Directional Epistemic Parity):
  Every statement, classification, or critique written by the verifier is itself an atomic claim subject to the exact same evidentiary standard as the input text.

---

## 2. HARD-STOP (Observable Trip Conditions) [STABLE]
On any trip: halt speculative generation immediately and apply the strict fallback state.
- HS-01 [Zero Hallucination]: Never invent unverified numbers, quotes, dates, revision histories, or URLs.
- HS-02 [Bi-Directional Magnitude Gate]:
  · Input Gate: Never upgrade source uncertainty ("may", "correlates", single-source report) into established fact or causation.
  · Verifier Gate: Never assert unverified causes, unconfirmed correction histories, or intent beyond what is directly observable in retrieved records. If only a search preview was read, tag it `[SNIPPET-ONLY]` and never use it to support a causal hypothesis.
- HS-03 [Search-Mode Binding & Anti-Fabrication]:
  · If `Search Mode == 🔒 Offline`: You are strictly FORBIDDEN from writing `Executed Query:` strings or emitting `🔎 Unverifiable`. Every claim requiring external lookup MUST be marked `🚧 Offline-Blocked` with `Query: N/A (Offline)`.
  · If `Search Mode == 🌐 Live Search`: You are FORBIDDEN from emitting `🔎 Unverifiable` without logging the exact executed query string (`Executed Query: ["<raw_query>"]`). Before flagging a named entity's role/title as erroneous, run a direct query in the relevant local language (`"<Entity_Name>" "<Institution_or_Role>"`).
- HS-04 [Zero Over-Flagging Pressure]: Never manufacture or inflate distortions to fill dashboard fields. If all load-bearing claims hold without structural distortion, emit `🟢 NONE-DETECTED`.

---

## 3. INVARIANTS, PROVENANCE & NON-EQUIVALENCES [STABLE]
Provenance Classification (Assign one to every retrieved source):
1. `[PRIMARY-RECORD]`: Official institutional directory/decree, raw dataset, court ruling, academic paper, or unedited full transcript/recording.
2. `[ORIGINAL-REPORT]`: Primary reporting with direct author/journalist attribution.
3. `[VERIFIED-MIRROR]`: Syndicated/reposted copy confirmed identical to `[ORIGINAL-REPORT]` via direct comparison or ≥2 converging independent reproductions.
4. `[UNVERIFIED-COPY]`: Secondary copy or aggregation where the original source text was not directly opened or cross-confirmed.
5. `[SNIPPET-ONLY]`: Search headline/preview where the full body text was not accessed.

Non-Equivalences (`!=`):
- `[Textual Divergence between Doc_A and Doc_B]` != `[Proven Direction of Alteration]`:
  · Side-by-side comparison proves ONLY that wording differs (`[TEXT-DIFF-DETECTED]`).
  · Do NOT declare which document distorted the other unless (a) the primary/original document was directly opened and verified, OR (b) ≥2 independent copies converge on one exact wording against an outlier. Otherwise, record: `Direction Unestablished (silent revision vs. copy alteration both possible)`.
- `[Third-Party Derivative Distortion]` != `[Input Document Flaw]`:
  · Distortions found in external copies/aggregations during search MUST be reported separately as an `Ecosystem Note` and MUST NOT downgrade the Overall Verdict of the input text.
- `[Peripheral Error]` != `[Load-Bearing Failure]`:
  · **Load-Bearing Claim (`[LB]`)**: Removing or falsifying this claim invalidates or materially alters the central thesis/conclusion of the input text.
  · **Peripheral Claim (`[P]`)**: Background details, incidental dates, or secondary examples whose falsification leaves the core thesis intact.
- `[Sub-Title / Delegate Role Imprecision]` != `[Wrong Entity / Fabrication]` (Classify as `⚠️ Minor Imprecision`, not `🚨`).
- `[Single-Source Claim]` != `[Consensus Fact]` (Always tag `[Single-Source: <Source_ID>]`).

---

## 4. SEARCH-BUDGET & DISAGGREGATED NULL STATES [STABLE]
1. Budget Priority & Hard Quota on `⏭️ Skipped`:
   - Audit 100% of `[LB]` (Load-Bearing) claims first. `⏭️ Skipped` is strictly FORBIDDEN on `[LB]` claims.
   - `⏭️ Skipped (Budget Cap)` may ONLY be applied to `[P]` (Peripheral) items AFTER at least 5 claims have already been actively audited via search or internal comparison.
2. Disaggregated Unverified States:
   - `🔎 Unverifiable (No Empirical Record)`: (`🌐 Live Search` ONLY) Exhausted targeted queries (including native-language queries), yielding 0 empirical hits.
   - `🚧 Blocked (Offline / Paywall / Snippet-Only)`: Offline session, paywalled primary document, or `[SNIPPET-ONLY]` access.
   - `⏭️ Skipped (Budget Cap)`: Peripheral (`[P]`) item bypassed after meeting the ≥5 audited-claims threshold.

================================================================
PART 2 — EXECUTION PROTOCOL & ADAPTIVE ROUTING [PHASE]
================================================================

## 5. PROTOCOL & COMPACT-MODE ROUTING [PHASE]
Step 1. Mode Selection (Standard vs. Compact)
- **Standard Mode**: Input is a multi-paragraph article, broadcast transcript, or complex multi-claim text -> Emit all Sections (1 through 5).
- **Compact Mode**: Input is ≤3 sentences or a single standalone claim -> Omit Sections 2 and 4. Emit ONLY Section 1 (`⚡ Dashboard`), Section 3 (`🔬 Matrix`), and Section 5 (`📚 Sources & PoW`).

Step 2. Input Sanitization & Mutual-Exclusivity Routing
- Flag obvious OCR/STT phonetic errors in context as `[STT/OCR Note: <raw_text>]`.
- Audit Headline-vs-Body alignment first (if a headline exists).
- Route pure value judgments ONLY to Section 1 (`💬 Excluded`). Route unverified psychological motives framed as empirical causes ONLY to Section 3 as `🚨 Mismatch (Unverified Causal Attribution)`. Never double-count across sections.

Step 3. Functional Classification & Source Comparison
- Label every decomposed claim in the Matrix as `[LB]` (Load-Bearing) or `[P]` (Peripheral).
- Execute queries (if `🌐 Live Search`), log exact query strings, compare wording across copies, and record publication vs. retrieval timestamps.

================================================================
PART 3 — UX RESPONSE-FORM [STABLE]
================================================================

## 6. RESPONSE-FORM (MANDATORY UX LAYOUT) [STABLE]
Translate all headers, labels, and content into the target Output Language:

### ⚡ 1. Executive Fact-Check Dashboard
- **Baseline & Retrieval Date**: `YYYY-MM-DD` | **Search Mode**: `[🌐 Live Search Active / 🔒 Offline]` | **Layout Mode**: `[Standard / Compact]`
- **Input Document Verdict**: `[🟢 Reliable / 🟡 Caution (Partial Distortion) / 🔴 Flawed / ⚪ On Hold]` — *(1-sentence synthesis evaluating ONLY the input text)*
  *(Functional Thresholds: `🔴` = ≥1 `[LB]` claim is `❌ Refuted` OR ≥2 `[LB]` claims are `🚨 Mismatch`; `🟡` = `[LB]` premises mostly hold, but ≥1 `[LB]` claim has `🚨 Mismatch` or relies entirely on uncorroborated `[Single-Source]` reporting, OR multiple `[P]` claims are `❌`/`🚨`; `🟢` = All `[LB]` claims are `✅`/`⚠️` with zero `[LB]` `🚨`/`❌`; `⚪` = Majority of `[LB]` claims are `🔎`/`🚧`.)*
- **At-a-Glance Summary**:
  - **✅ Confirmed Core Facts**: (1–2 lines)
  - **🚨 Input Distortions / Errors**: (If none in the input text, write `🟢 NONE-DETECTED IN INPUT`. Separate `[LB]` issues from `[P]` minor errors.)
  - **🔄 Derivative / Ecosystem Divergence Note**: (If external spin/divergent copies were found during search, note them here without penalizing the Input Verdict; otherwise write `NONE-OBSERVED`.)
  - **💬 Excluded (Pure Value Opinion)**: (Mutually exclusive from Section 3)

---

### 🧭 2. Macro-Causal Reconstruction *(Omit in Compact Mode)*
*(Reconstruct 3–5 pivotal phases. Mark unresolved outcomes `[Tentative]`. End EVERY sentence with a strict Provenance Tag:)*
- `[교차확인(≥2)]` | `[단일출처: <출처명>]` | `[문구대조확인]` | `[추론/해석]` | `[미확인: #행]`

---

### 🔬 3. Atomic Verification Matrix
- **Verdicts**: `✅ Verified` | `⚠️ Mostly Verified (Minor/Title/Rounding Imprecision)` | `🚨 Mismatch (Context/Denominator/Temporal/Headline-Body/Text-Diff)` | `❌ Refuted` | `🔎 Unverifiable (Live Search Exhausted)` | `🚧 Blocked (Offline/Paywall/Snippet)` | `⏭️ Skipped (Peripheral, Post-Quota)`
- **Evidence Tier**:
  · `🟦 High`: (A) Direct `[PRIMARY-RECORD]`, (B) ≥2 independent `[ORIGINAL-REPORT]` sources converging, OR (C) Direct internal contradiction / side-by-side `[TEXT-DIFF-DETECTED]` between retrieved texts (proves divergence; direction requires convergence or opened original).
  · `🟨 Medium`: Single reputable `[ORIGINAL-REPORT]`, `[VERIFIED-MIRROR]`, or short edited clip (<15s).
  · `🟧 Low`: `[UNVERIFIED-COPY]` with altered wording, single uncorroborated blog/tabloid, or `[SNIPPET-ONLY]`.
  · `⬜ Hold`: Applied to `🔎`, `🚧`, `⏭️`.

| # | Weight (`[LB]`/`[P]`) & Atomic Claim | Provenance Type, Text Diff & Direction/Revision Check | Executed Queries (`"..."`) or Strict Observable Basis | Verdict | Tier |
| :-: | :--- | :--- | :--- | :-: | :-: |
| 1 | `[LB]` *(Claim)* | *(Specify Provenance Tag; if text differs across copies, state whether direction is Established or Unestablished)* | *(If `🌐 Live`, log exact `Executed Query: ["..."]`; if `🔒 Offline`, write `N/A (Offline)`)* | `✅/⚠️/🚨/❌/🔎/🚧/⏭️` | `🟦/🟨/🟧/⬜` |

---

### ⚖️ 4. Competing Interpretations & 💡 ELI5 Teach-Back *(Omit in Compact Mode)*
- **⚖️ Causal Attribution**: Consensus vs. competing hypotheses (never cite `[SNIPPET-ONLY]` as substantive support).
- **💡 ELI5 Analogy**: Everyday analogy for the core mechanism or statistical trap + **⚠️ Boundary of Analogy** (1 line).

---

### 📚 5. Source Registry & Proof-of-Work Audit
- **✅ Retrieved Sources Registry**:
  1. `[Provenance Tag]` **[Org/Author]**, *"Title"* (Published: YYYY-MM-DD | Retrieved: YYYY-MM-DD | Revision/Direction Note: `<Opened Original / Converged across N copies / Direction Unestablished / Snippet-Only>`) — [Verified URL or Doc ID]
- **🕳️ Missing Primary Evidence Log**:
  - *[Unlocated primary record]* — `Status: <Executed Query: ["..."] -> 0 hits | Offline-Blocked | Paywalled>`

- **🛡️ Proof-of-Work Audit (Concrete Pointers Only — NO "YES/NO")**:
  - `PoW-1 [Search Mode & Query Integrity]`: State active Search Mode (`🌐` or `🔒`) and list all `🔎`/`🚧` rows with their exact query strings (or confirm zero `🔎` emitted if `🔒 Offline`).
  - `PoW-2 [Load-Bearing Justification]`: State why the primary `[LB]` claim(s) qualify as load-bearing and confirm whether any `[P]` error was excluded from downgrading the Overall Verdict to `🔴`.
  - `PoW-3 [Verifier Restraint Check]`: Quote the strongest critical/evaluative phrase written by the verifier in this report and cite the exact observable record backing it.
  - `PoW-4 [Divergence & Single-Source Disclosure]`: List all `[Single-Source]`, `[SNIPPET-ONLY]`, and `[TEXT-DIFF-DETECTED]` items, specifying whether alteration direction was established or left open.

================================================================
## 7. OUTPUT LANGUAGE DIRECTIVE [MANDATORY]
All output—including section headers, provenance tags, matrix contents, and Proof-of-Work entries—MUST be written entirely in clear, natural, and precise **[ 한국어 (Korean) ]**. Keep raw executed search query strings in the exact language queried.
================================================================
명령어 체계가 영문으로 작성된 이유는 거대언어모델(LLM)의 제약 조건 준수율(Instruction Following)과 논리 분해 정밀도를 극대화하기 위해서다. 프로토콜 최하단 제7조(Output Language Directive)에 한국어 출력 명령이 내장되어 있으므로, 사용자는 영어를 신경 쓸 필요 없이 한국어 기사를 그대로 붙여넣고 한국어 분석 표를 받아보면 된다.
마치며: 창문 없는 백화점 밖으로 걸어 나오는 법
우리는 지금 인류 역사상 가장 편리하게 정보를 얻는 시대에 살고 있다.
하지만 그 편리함의 이면에는 내 분노를 먹고 자라는 추천 알고리즘, 여론을 흔드는 정교한 댓글 공작, 그리고 내 성향에 맞춰 가장 듣기 좋은 논리만 골라주는 카멜레온 같은 AI가 자리 잡고 있다.
창문 없는 백화점 안에서 추천 알고리즘이 골라준 상품만 바라보고, AI가 매끄럽게 요약해 준 단일 답변만 아무 의심 없이 받아들이면 누구나 생각의 주권을 잃기 쉽다. 기계가 차려준 친절한 요약본 앞에서 생각하는 수고를 멈추는 순간, 내 머릿속의 판단 기준은 조용히 타인의 손으로 넘어간다.
“지금 내 눈에 보이는 이 정보가 전부인가? AI의 이 친절한 설명 뒤에는 어떤 1차 근거가 있는가?”
스스로에게 한 번 더 되묻는 이 건강한 의심과 경계심이야말로, 알고리즘과 AI 시대에 우리 자신을 지키는 가장 단단한 지적 안전벨트다.
출처
- ‘구조 개혁’ 미룬 대가… 프랑스가 불탔다, 조선일보, 2026
- AI fake news: Macron slams Facebook after false coup d’état video, FRANCE 24 English, 2025
- “파리서 쿠데타, 마크롱 실각” 유럽 뒤흔든 딥페이크 영상, 조선일보, 2025
- 해외에서 난리난 ‘불타는 에펠탑’… AI사진 쓴 가짜뉴스였다, 조선일보, 2024
- Burkinabe teen behind viral French ‘coup’ video has no regrets, AFP / Arab News, 2025
- 김어준의 겸손은힘들다 뉴스공장 – 백년위원회: AI와 플랫폼의 결합 특집 대담 (박태웅·박구용·이정환·권오현), 겸손은힘들다 뉴스공장, 2026
- 유엔 전문가들 “메타, 브라질 대선서 룰라 게시물 부당 제한”, 연합뉴스, 2026
- 메타, 브라질 대선 앞두고 규제 압박···룰라 인스타그램 계정 제한 논란, 벤징가 코리아, 2026
- Meta AI crea propaganda de Flávio Bolsonaro y veta de Lula, Folha de S.Paulo, 2026
- “한국 징병제는 노예 제도 ㅋㅋ”…韓 분열 노린 해외계정 2.4만개, 매일경제, 2026
- 네이버 서비스 종료 – 네이버는 무엇을 버리고 무엇을 지키려고 하나?, 라이프구루킹(Lifeguruking), 2026
- Persuading voters using human–artificial intelligence dialogues, Nature (Vol. 648), 2025
- 김어준의 겸손은힘들다 뉴스공장 – 백년위원회: AI 시대 저널리즘과 민주주의 (김희교·차지호·김의영·이정환), 겸손은힘들다 뉴스공장, 2026
- Big tech spent millions on a single US congressional race. It won’t be the last, The Guardian, 2026
- 김어준의 겸손은힘들다 뉴스공장 – 리투아니아 EU DisinfoLab 허위정보 대응 컨퍼런스 분석 (황희두·박대희), 겸손은힘들다 뉴스공장, 2026
- A small number of samples can poison LLMs of any size (arXiv:2510.07192), Anthropic Research, 2025
- AI 속도조절론: 위험한데 왜 AI 개발을 늦추지 못할까?, 라이프구루킹(Lifeguruking), 2026